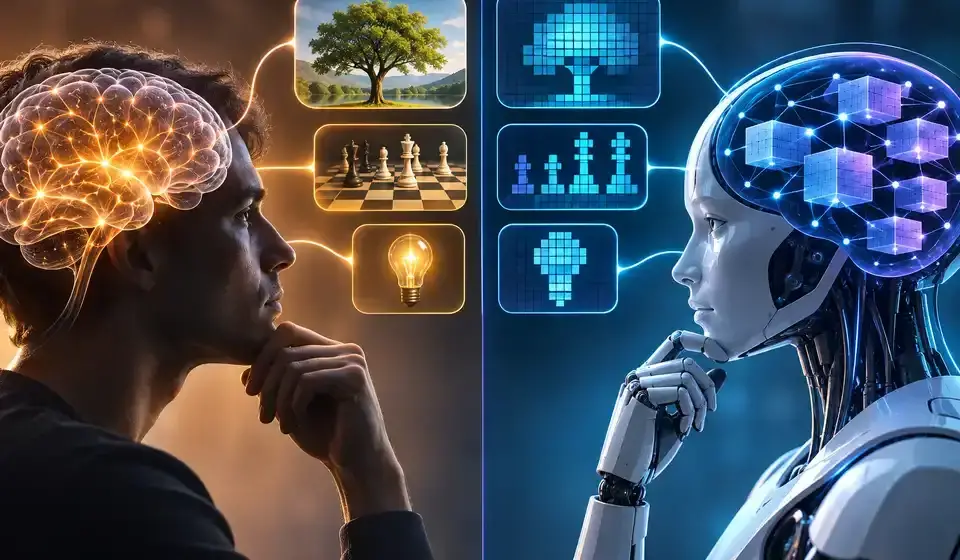
Австралийско изследване установява, че човешкият мозък разграничa по-ясно кой извършва действието и кой е обектът в изречения, отколкото вътрешните представяния на някои езикови модели.
Изследователите сравняват мозъчната активност при четене на фрази с репрезентациите, които формират различни AI системи, и откриват фундаментална разлика в начина, по който се кодира смисълът.
Как беше направено изследването
Учени създават 108 английски изречения, чиито думи остават почти еднакви, но подредбата и граматическите роли се сменят. Като пример са дадени двойките „операторът донесе оборудването на режисьора“ и „режисьорът донесе оператора при оборудването“.
Тридесет участници четат тези изречения в апарат за ядрено-магнитен резонанс с мощност 7 тесла, докато учените записват активността чрез функционален ЯМР.
Получените данни са сравнени с резултатите от четири типа изчислителни модели: от прости методи за осредняване на думи до трансформерни архитектури и модели, които изрично отчитат граматическите роли.
Какво показаха резултатите
При двойки изречения с почти идентичен речников състав, трансформерните модели имат отрицателна корелация с активността в езиковите зони на мозъка; стойността е около −0,05, което означава, че техните вътрешни репрезентации не разграничават добре разменените роли на участниците.
Моделите, които кодирано отчитат структурата на изречението, показват положителна корелация с мозъчната активност. При хибридния модел този показател достига около 0,07. Разликата между двата модела, които отчитат структурата, не е статистически значима.
Когато са сравнени всички 5778 двойки изречения — повечето от които се различават и по речников състав — трансформерните архитектури като цяло съвпадат по-добре с човешките оценки за семантична близост. Това подсказва, че тези модели са добри в улавянето на лексикални разлики, но затруднени в точната идентификация кой е извършител и кой е обект.
В допълнителен онлайн експеримент 486 участници оценяват степента на сходство между изреченията. Когато думите в двойките са почти идентични, човешките оценки съвпадат най-точно с резултатите от хибридния модел, който отчита граматическите роли.
Освен това отделен тест показва, че GPT-4 — когато му бъдат представени самите изречения — може да оцени семантичната им близост по-ефективно, отколкото се предполага въз основа на неговите вътрешни векторни репрезентации.
С други думи, способността на един езиков модел да борави с граматически категории не означава непременно, че неговата вътрешна архитектура организира смисъла по същия начин, по който това прави човешкият мозък.
Проучването се фокусира върху кратки, специално съставени фрази, а не върху естествен диалог, и не разглежда как това установено несъответствие може да повлияе на практическото представяне на чатботовете.

КОМЕНТАРИ (0)