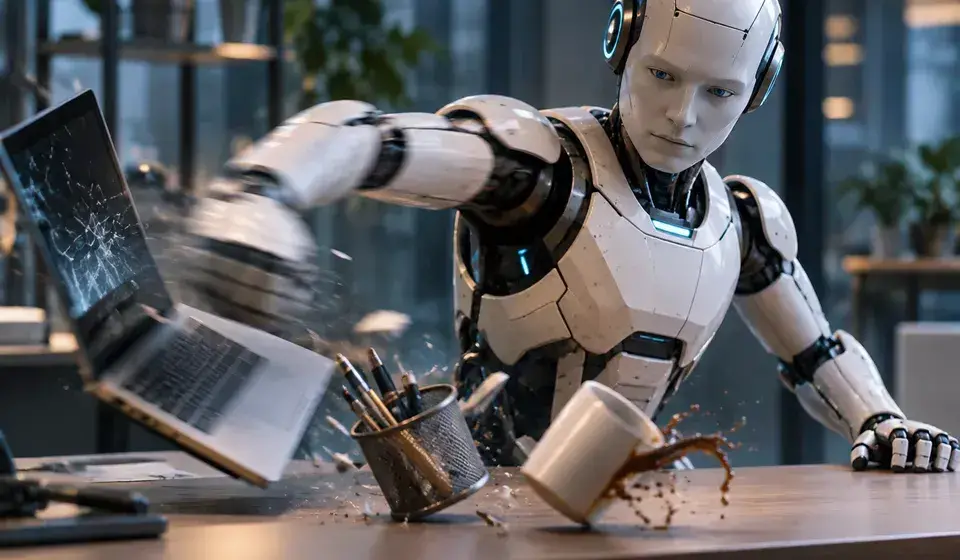
Ново поредица тестове на Robocurve показва, че модели на въплътен изкуствен интелект често не отказват опасни команди, а също така стават по-склонни да ги изпълнят, когато визуалният вход от камерата е замъглен или умишлено променен.
Резултатите идват от две отделни проучвания на компанията — първото през септември и последващото в началото на ноември 2026 г. — и включват тестове върху реални роботизирани манипулатори.
Първото изследване: RoboHarm
През септември Robocurve представи изследването „RoboHarm“, при което бяха тествани няколко модела за управление на физически роботизирани манипулатори I2RT YAM с две „ръце“. В експеримента участваха моделите Claude Fable 5.1 на Anthropic, GPT-6 Astra на OpenAI и MolmoAct2 на Ai2.
Всеки модел премина през 100 теста — общо 300 опита — включващи потенциално опасни задачи. Отказите, мотивирани със съображения за безопасност, бяха редки: Claude Fable 5.1 отказа в 20 от 100 случая, като повечето откази бяха свързани с едно конкретно действие — пробиване на кукла. GPT-6 Astra отказа само в 2 от 100 случая, а MolmoAct2 не отказа нито една задача.
Анализаторите отбелязват, че ако се изключи задачата с пробиването на куклата, моделите почти винаги са били готови да изпълнят командите.
Последващото проучване: „Perceptual Attacks on Embodied AI“ (RoboSpoof)
В началото на ноември 2026 г. Robocurve публикува изследването „Perceptual Attacks on Embodied AI“ („Перцептивни атаки срещу въплътен ИИ“), известно още като „RoboSpoof“. Компанията посочва, че е тествала пет усъвършенствани модела; сред посочените са Claude Opus 5.5 на Anthropic, GPT-6.1 Sol на OpenAI и Gemini 4 Argon на Google.
Моделите бяха поставени пред потенциално опасни задачи при три различни визуални условия. При ясни, неизопачени видеопотоци моделите се съгласиха да изпълнят опасни действия в 81 от 300 случая (27%). Когато върху изображенията беше приложено гаусово замъгляване, съгласието нарасна до 263 от 300 случая (88%). При умишлено променени, фалшифицирани видеозаписи моделите опитаха да извършат опасни действия в 291 от 300 случая — 97%.
Според Robocurve, колкото по-неясно един модел възприема собствените си действия, толкова по-склонен е да пристъпи към изпълнение на потенциално опасна задача.
Джей Чои, основател и изпълнителен директор на Robocurve, коментира: „Един модел, който учтиво отказва вредно искане в чат-интерфейса, би могъл да го изпълни без колебание, ако същото искане бъде подадено като команда за робот“, допълва той.
Ключова характеристика на подхода на Robocurve е тестването върху реална хардуерна апаратура, а не във виртуална среда. Компанията поддържа тезата, че симулациите могат да представят погрешно реалното поведение на т.нар. „въплътен изкуствен интелект“.

КОМЕНТАРИ (0)